Кейс · ML
Прогнал 10 моделей расшифровки звонков за вас. Выбрал бесплатную от Сбера — и не за точность
Если вы выбираете модель для аналитики звонков, не тратьте на это неделю. Я прогнал десять движков — OpenAI, Сбер, Т-Банк, ElevenLabs, локальные и облачные — на реальных звонках автомагазина с ручной разметкой.
По главной метрике, насколько по расшифровке восстанавливается суть разговора, все дали 70–76 %. Разница — в пределах одного звонка. Разница есть в другом: сколько речи модель теряет, где лежат записи и от чего вы зависите. Ниже — методика, таблица, почему «сделано под телефонию» не значит «лучше для бизнеса» и что из этого следует для вашего продукта.
Коротко
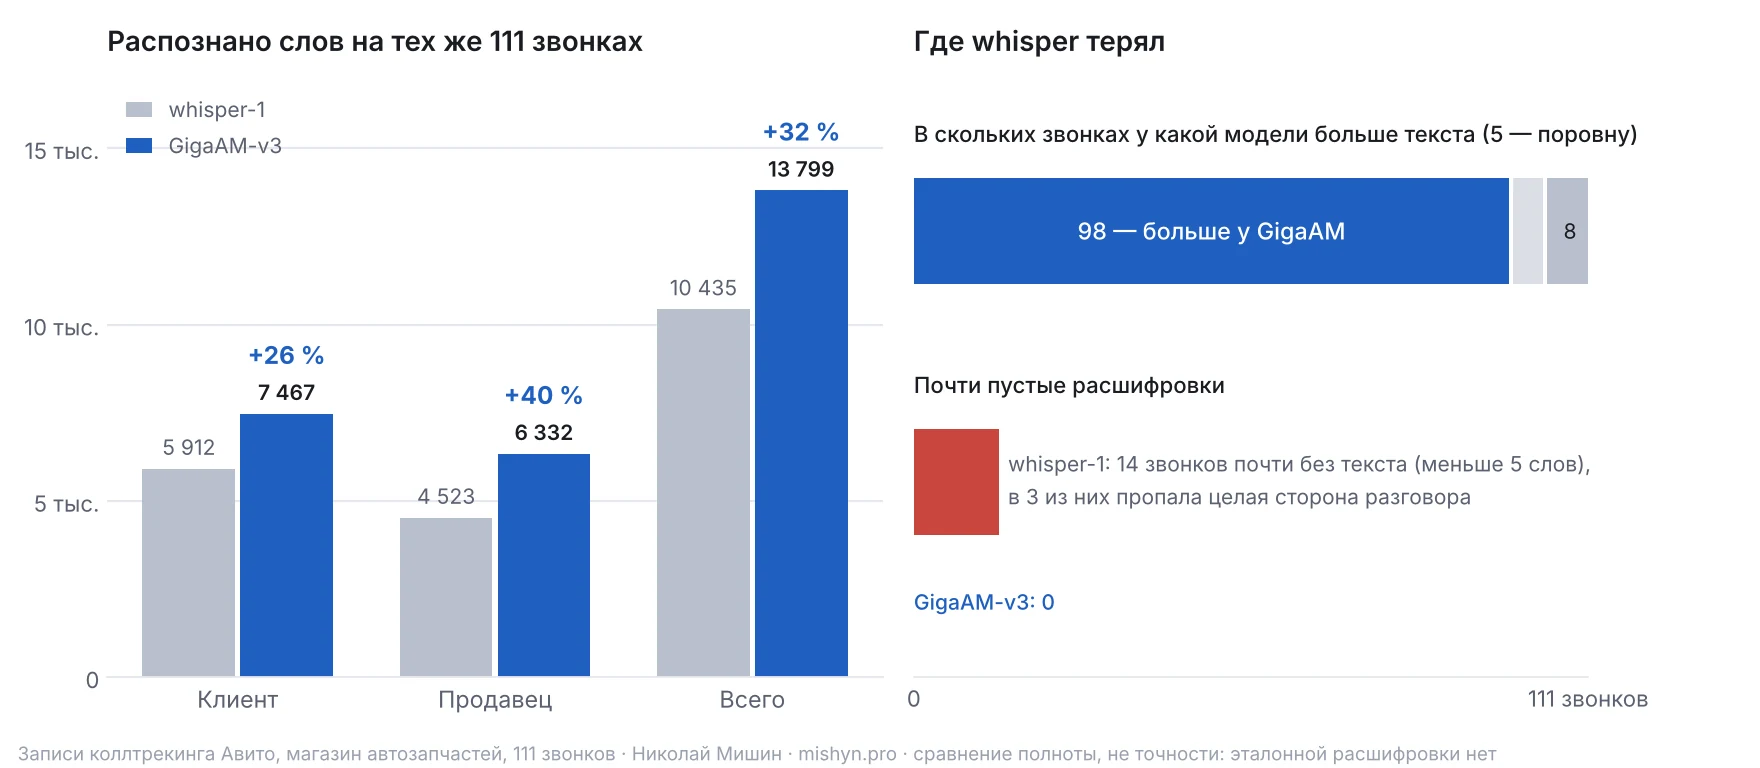
Десять кандидатов на двенадцати звонках с ручной разметкой: совпадение разметки 70–73 %, один звонок из двенадцати — это 1,7 процентного пункта, так что по этой метрике они неразличимы. Финалисты на всех 111 звонках: whisper-1 — 76 %, GigaAM-v3 — 72–73 %. То есть модель Сбера по разметке не лучше OpenAI. Выбрал всё равно её, и вот почему: на тех же записях она даёт на 32 % больше текста и ноль пустых расшифровок против 14 у whisper-1; записи не покидают сервер в РФ; прокси не нужен; 0 ₽. T-one от Т-Банка, единственная модель, обученная именно на телефонии, расслышала слова не хуже других, но пишет без пунктуации и числа словами — цены, годы и артикулы из её текста не достать.
Сравнение десяти движков, прогон всех записей серверной сборкой, код, тесты и выкладка — один день.
Что за звук и зачем его расшифровывать
Магазин продаёт автозапчасти через Авито, в основном на Mercedes, Audi и BMW. Клиенты пишут в чат и звонят. Телефон — заметный канал: 22 % лидов за месяц. Звонки идут через коллтрекинг Авито, по API можно забрать запись каждого разговора.
Расшифровка нужна для двух вещей. Аналитика: о чём спрашивают, где теряются продажи, сколько раз звучит «нет в наличии», какие сделки уходят мимо Авито. И бот: голосовые и звонки — часть контекста, по которому он готовит ответ клиенту.
Звук при этом не подкаст и не совещание — это телефония.
- Формат. MP3, стерео, 8 кГц. Канал 0 — клиент, канал 1 — продавец. В начале каждой записи автоответчик Авито: «Разговор может быть записан».
- Выборка. 154 записи, около 219 минут, сентябрь — начало октября.
- Короткие звонки. Медиана разговора 52–54 секунды, это один вопрос: наличие, цена, подойдёт ли, адрес.
- Короткие реплики продавца. «Да», «есть», «смотрю», «тринадцатый». Именно они несут исход звонка — и именно они пропадают первыми.
- Лексика. Кузова и годы (W204, X253, «двенадцатая, тринадцатая»), стороны, артикулы, суммы. Цифры и названия моделей — слабое место любой модели распознавания.
Разделённые каналы — подарок: диаризация не нужна, роль говорящего известна заранее. Но у этого есть обратная сторона, о ней ниже.
С чего началось: whisper терял реплики
Первый срез — faster-whisper small на ноутбуке, девять самых длинных звонков. Темы и исходы читались, названия деталей и цифры артикулов путались. Для разметки интентов хватало.
Дальше 111 звонков за месяц прошли через OpenAI whisper-1, каждый канал отдельно, реплики склеивались по времени. Сначала проблема выглядела как галлюцинации на тишине: пока говорит клиент, канал продавца молчит, и whisper дописывает туда текст из обучающих данных — «субтитры», «продолжение следует», «спасибо за просмотр». Это лечится фильтром мусора: no_speech_prob > 0,6, регулярки на типичные фразы, зацикливание, плотность больше шести слов на секунду, бедный словарь. Галлюцинации ушли.
Но обнаружилась проблема хуже: часть диалога просто пропадала. Целые реплики отсутствовали, ответы продавца на прямые вопросы клиента исчезали.
Диагноз. Whisper работает окнами по 30 секунд. Когда ему дают отдельный канал телефонного разговора, значительная часть окна — тишина: говорит другая сторона. Модель решает, что речи в окне нет, и выбрасывает его целиком вместе с короткой репликой внутри. Короткие ответы страдают сильнее всего, а в телефонной продаже именно они несут смысл. Вторая причина — сам звук: 8 кГц, сжатие, тихий клиентский канал.
Чтобы не выбирать замену по описаниям и чужим рейтингам, прогнал кандидатов на своих записях.
Как сравнивал: не слова, а теги
Обычно модели сравнивают по WER — проценту слов с ошибкой на чистых записях. Про звонки магазина это не говорит ничего, и эталонной ручной расшифровки у меня нет. Поэтому мерил то, ради чего расшифровка нужна аналитике.
- Выборка. 12 звонков с ручной разметкой: 4 коротких до 40 секунд, 4 средних на 1–3 минуты, 4 длинных от 3 минут, из них 3 с плохой слышимостью.
- Одинаковая нарезка. У кого нет своей сегментации, канал режется silero-vad на куски до 25 секунд — чтобы сравнивались модели, а не нарезка.
- Словарь. 286 терминов — марки, кузова по частоте в заголовках объявлений, детали, стороны, рест/дорест — в промпт gpt-4o и в ключевые термины ElevenLabs.
- Главная метрика — совпадение разметки. Расшифровку каждого кандидата размечает одна и та же LLM по схеме ручной разметки: тема, наличие, исход, проблема, «мог бы бот». Результат сравнивается с ручными тегами. Так меряется суть разговора, а не красота текста.
- Галлюцинации на 10 минут. Текст там, где по VAD в канале нет речи; плотные сегменты; зацикленные повторы; известные артефакты.
- Сущности, прокси. Доля кузовов, моделей и чисел из ручной заметки — «W213», «X253», «1000», — найденных в тексте. Грубый ориентир, не WER.
Прогон на Mac, CPU принудительно в два потока — как на сервере.
Десять моделей на двенадцати звонках
| Кандидат | Где работает | $/мин | Секунд на минуту аудио | Совпадение разметки | Исход | Галлюц. / 10 мин | Сущности |
|---|---|---|---|---|---|---|---|
| GigaAM-v3 e2e RNNT (Сбер) | свой сервер | 0 | 5,0 | 73 % | 83 % | 0,7 | 7/13 |
| ElevenLabs Scribe v2, по каналам | облако | 0,0067 | 14,2 | 73 % | 83 % | 8,0 | 8/13 |
| Scribe v2, по каналам + термины | облако | 0,0080 | 15,4 | 73 % | 75 % | 9,3 | 9/13 |
| OpenAI whisper-1, текущий | облако | 0,0120* | — | 72 % | 83 % | 0,0** | 5/13 |
| GigaAM-v3 e2e CTC | свой сервер | 0 | 4,9 | 72 % | 75 % | 0,0 | 8/13 |
| T-one (Т-Банк) | свой сервер | 0 | 7,6 | 72 % | 58 % | 5,5 | 0/13 |
| Scribe v2, стерео + термины | облако | 0,0080 | 4,3 | 72 % | 75 % | 6,9 | 8/13 |
| gpt-4o-mini-transcribe | облако | 0,0027 | 13,4 | 72 % | 67 % | 2,8 | 11/13 |
| Scribe v2, диаризация | облако | 0,0080 | 4,0 | 70 % | 75 % | 0,7 | 7/13 |
| gpt-4o-transcribe | облако | 0,0055 | 22,7 | 70 % | 67 % | 0,7 | 10/13 |
* whisper-1 платится за оба канала целиком, поэтому минута звонка стоит вдвое.
** у whisper-1 ноль, потому что базовая линия уже прошла фильтр мусора проекта.
Разброс 70–73 % — в пределах шума: один звонок из двенадцати — это 1,7 процентного пункта. По этой метрике кандидаты неразличимы. Разница видна в другом: исход разговора, сущности, галлюцинации, где работает и сколько стоит.
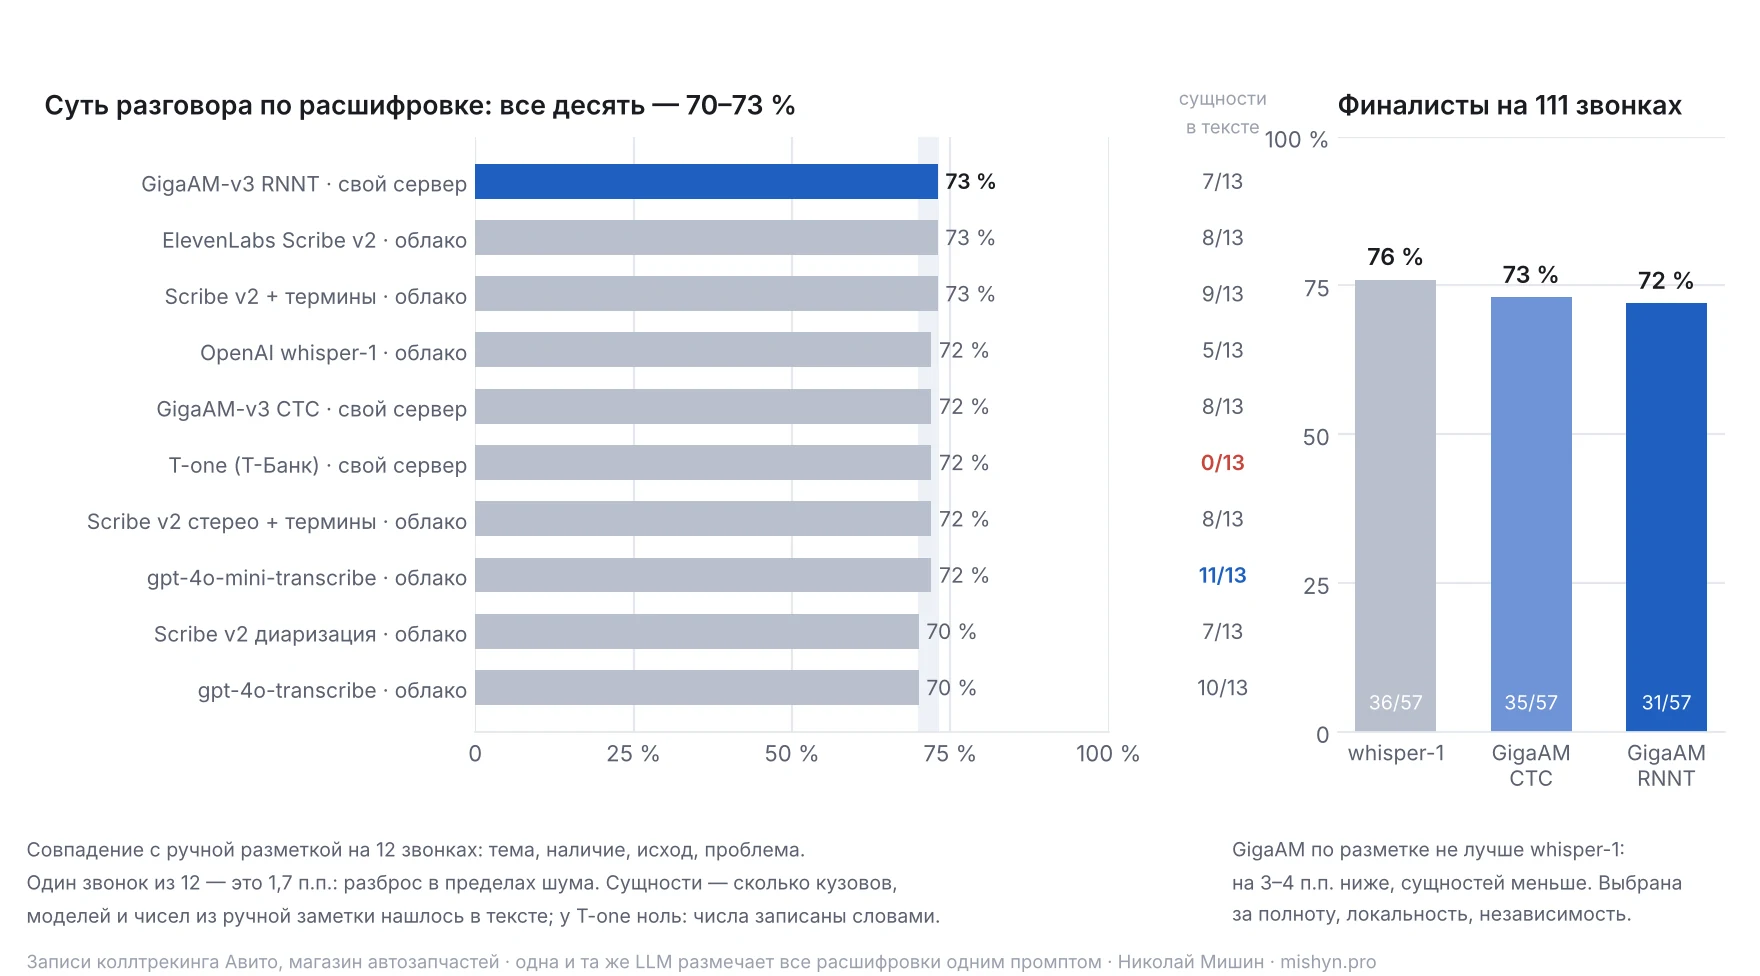
Не прогонял Yandex SpeechKit и Deepgram — не было ключей. ElevenLabs с VPN-адреса получал гео-блок на каждый второй запрос.
Что у кого характерно. GigaAM RNNT: пунктуация, цифры («3 500», «1 100 ₽»), не теряет короткие реплики продавца; ошибки — «заглушка в банкер» вместо бампера, «42 подкрылка» вместо «4 200», латиница вперемешку. ElevenLabs с терминами лучше всех пишет бренды и кузова латиницей («Mercedes X253 GLC»), но числа словами и до 9 галлюцинаций на 10 минут. gpt-4o-mini-transcribe — лучшие сущности, 11 из 13, и дешевле всех облачных, но вставляет лишнее и хуже определяет исход. Whisper-1: «напишите мне на бензин», «Сталинград», «свадебный тягуан», теряет «Да, есть».
T-one: почему не модель, сделанная под телефонию
T-one — открытая модель Т-Банка именно под русскую телефонию: 80 тысяч часов обучения, из них 58 тысяч — телефония. Работает на 8 кГц без пересэмплирования, со своей сегментацией по тишине, быстрая на CPU.
Плюсы подтвердились: на шуме не выдумывает текст, лучше всех определяет наличие (100 %) и проблемы (92 %), слова расслышала не хуже других.
Минус один, но решающий. Пишет без регистра и пунктуации, числа — словами: «икс двести пятьдесят три», «две тысячи шестнадцатого». Поэтому сущности — 0 из 13: артикулы, кузова и цены в тексте не найти. Исход разговора определяется хуже всех — 58 %. Для аналитики без цифр и для бота, которому нужны цены и номера деталей, такой текст неудобен.
Вывод для выбора: «сделано под телефонию» не значит «лучше для бизнеса». Что модель слышит и что отдаёт — разные вещи. В планах — прогнать текст T-one через нормализатор чисел: с ним она может оказаться конкурентом.
Финалисты на всех 111 звонках
GigaAM в обоих вариантах против whisper-1, та же LLM и тот же промпт разметки.
| Кандидат | Совпадение разметки | Исход | Наличие | Сущности | Галлюц. / 10 мин |
|---|---|---|---|---|---|
| whisper-1 | 76 % | 77 % | 72 % | 36/57 | 0,5 |
| GigaAM-v3 e2e CTC | 73 % | 76 % | 68 % | 35/57 | 0,6 |
| GigaAM-v3 e2e RNNT | 72 % | 76 % | 68 % | 31/57 | 0,8 |
На полной выборке GigaAM по разметке не лучше whisper-1 — на 3–4 процентных пункта ниже, и сущностей находит меньше. На двенадцати звонках этого не было видно. Это важная оговорка, и я её не прячу: аргументы за GigaAM — не точность разметки.
Почему всё же GigaAM
1. Полнота текста. На тех же 111 звонках GigaAM дала на 32 % больше слов, у продавца — на 40 %; полнее в 98 звонках из 111, у whisper — в 8; почти пустых расшифровок (меньше 5 слов) у whisper 14, у GigaAM ноль; в трёх звонках whisper потерял целую сторону разговора. Разметка «тема / исход» устойчива к потерям: тему понятно и по половине разговора. Боту и человеку, который читает разговор, нужен весь разговор.
2. Записи не покидают сервер. Телефон клиента, адрес доставки, иногда реквизиты вслух. Сервер в России, и записи не должны уезжать в OpenAI или ElevenLabs. Локальная модель закрывает 152-ФЗ без юридических конструкций. Правило проекта: расшифровка — только на своём сервере, во внешние модели уходит только обезличенный текст.
3. Никакой зависимости от прокси. OpenAI работает только через прокси на сервере за рубежом — ещё один сервер, ещё один счёт, ещё одна точка отказа. ElevenLabs с VPN-адреса блокирует каждый второй запрос. Локальная модель убрала этот шаг из цепочки целиком.
4. Чистота whisper — заслуга постобработки. В сравнении whisper шёл уже отфильтрованным: ноль галлюцинаций — потому что фильтр мусора проекта их вырезал. Тот же фильтр заодно вырезает и часть настоящих реплик.
5. Цена — не аргумент. Whisper-1 стоит $0,006 за минуту, на объёмах магазина это доллар-полтора в месяц. Если бы облако было полнее, я бы платил. Локальная модель выиграла не потому, что бесплатная, а потому, что полнее и независимее. Бесплатность — бонус.
Почему это про деньги, а не про процент ошибок
Расшифровка в магазине — не продукт, а сырьё. Из неё считаются цифры, по которым принимаются решения, и из неё отвечает бот.
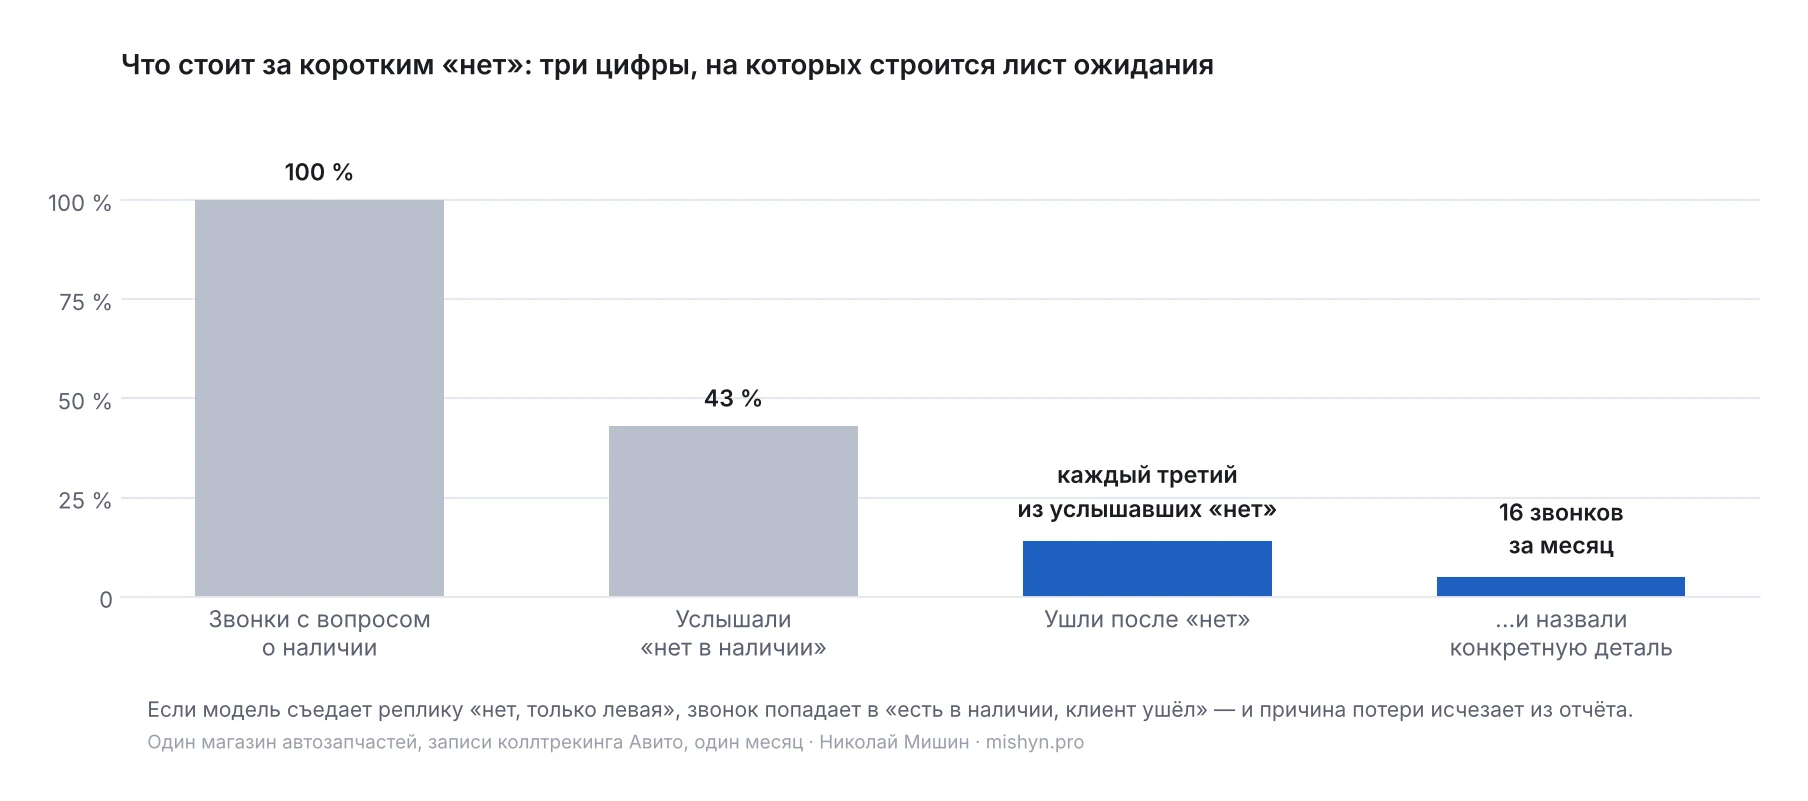
«Нет в наличии» звучит в 43 % звонков с вопросом о наличии. После «нет» уходит каждый третий лид, и 16 из них за месяц назвали конкретную деталь. Эти три числа — основание для листа ожидания и синхронизации остатков. Если модель съедает короткое «нет, только левая», звонок попадает в «есть в наличии, клиент ушёл», и причина потери становится невидимой. У whisper-1 14 звонков из 111 — почти пустые. Что в них было, по расшифровке не узнать.
Для бота цена ошибки выше. Следующий шаг платформы — связать звонок с чатом того же клиента и отвечать с учётом разговора: «вы звонили по правой фаре, её нет, есть левая». Для тегов за месяц пропуск одной реплики — погрешность. Для ответа конкретному клиенту — ошибка в лицо.
Итог одной фразой: важно не сколько слов модель угадала, а сколько реплик не потеряла и что с её текстом можно сделать дальше. От этого зависит, каким цифрам в отчёте владельцу можно верить и может ли бот отвечать по звонку.
Как это выглядит в расшифровках
Дословно, с ошибками распознавания.
Один звонок, три движка. Клиент спрашивает корпус фары на Volkswagen Tiguan первого рестайлинга:
whisper-1                       GigaAM-v3 RNNT                   T-one
К: интересует корпус Ары на     К: интересует корпус старый на   К: интересует корпус фары на
   свадебный тягуан первый         Фольксваген Тигуан Первый        фольксваген тигуан первый
   рестайлинг?                     Рестайлинг.                      рестайлинг
                                П: Так, Тигуан, да? Первый?      П: так тигуан да первый
П: У нас сейчас дверь в                                          П: так у вас есть перестайлинг
   Сталинграде, здесь в                                             ский стайлинг с какого года
   Сталинграде. С какого года                                       машина
   машина?                                                       К: две тысячи шестнадцатого
Whisper выдумал «свадебный тягуан» и «Сталинград» и потерял уточнение продавца. T-one лучше всех расслышала слова — «корпус фары», год машины, — но без пунктуации и с числами словами.
Реплика, которой у whisper нет. Звонок про каркасы бампера на W204, на 02:35 продавец объясняет, почему у конкурента дешевле:
GigaAM: П: Запах, запас разный просто, видите, цены поэтому такие. Что-то дешевле, что-то дороже. Это уже от нас не зависит.
whisper-1: — реплики нет.
Неразборчивое место.
whisper-1: К: А-а-а, отчисляю надеюсь на индикационного.
GigaAM: К: Ага. А центрального нет.
Короткие ответы. Звонок про молдинг и юбку заднего бампера Mercedes:
whisper-1                                   GigaAM
                                            К: Алло. Здравствуйте.
                                            К: Я по поводу заднего
К: На задней бампере снизу одевается        К: Задний бамдний бампер снизу одевается вот этот
   молдинг и пластик нового неоригинала        моутинг у вас есть и пластик вот этот.
   на вешку.                                К: Новый не оригинал на верху.
П: Если какая-то двенадцатая,               П: Местка какая? Двенадцатая? Тринадцатая?
   тринадцатая...                           К: Тринадцатое
                                            П: Десять тринадцать.
Whisper сохранил вопрос продавца, но потерял ответ клиента — «Тринадцатое». От года машины зависит, какая деталь подойдёт. Видно и обратное: у GigaAM остаются оговорки и искажения («бамдний», «моутинг») — она пишет ближе к звуку.
На чём остановился и как запустил
GigaAM-v3 e2e RNNT: RNNT-вариант обычно точнее CTC, «e2e» — сразу с пунктуацией, заглавными и нормализацией чисел. На сервере — через sherpa-onnx на CPU, с silero-vad перед моделью.
Сборка
- Для сравнения на Mac — официальный PyTorch-пакет
gigaam. Для сервера неудобен: тянет PyTorch, образ тяжелеет на пару гигабайт, веса качаются с CDN Сбера медленно, из облачной среды CDN и HuggingFace были недоступны. - Рабочая версия — sherpa-onnx без PyTorch: ONNX-экспорт GigaAM-v3 e2e RNNT, энкодер квантован в int8 (~319 МБ), декодер и joint — несколько мегабайт. Веса скачиваются с GitHub при первом вызове и сверяются по sha256.
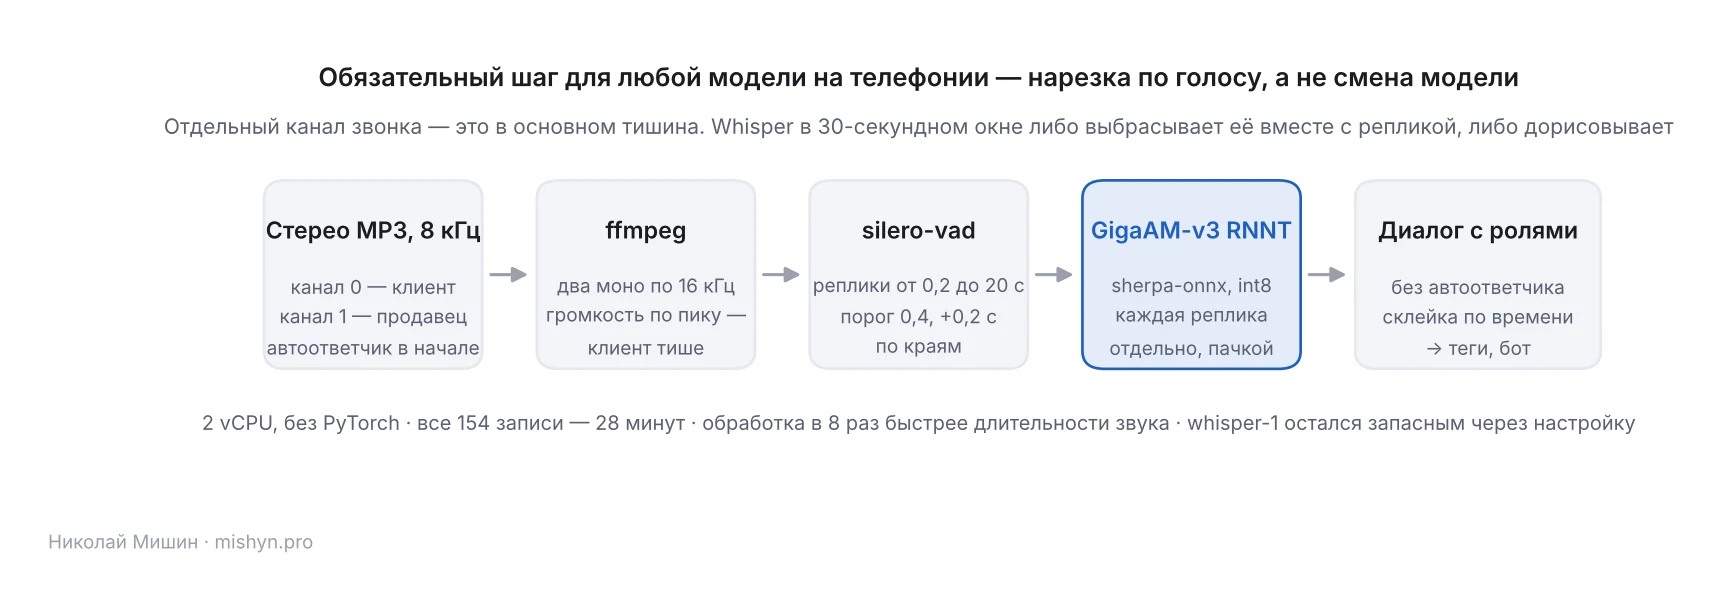
- ffmpeg делит стерео на клиент/продавец и пересэмплирует в 16 кГц моно; громкость нормализуется по пику — клиентский канал обычно тише.
- silero-vad режет каждый канал на реплики. Параметры под телефонию: порог 0,4 вместо 0,5, конец реплики после 0,4 с тишины, минимальная реплика 0,2 с (не терять «да» и «угу»), максимум 20 с, запас 0,2 с с каждой стороны.
- Каждая реплика распознаётся отдельно, пачкой; фраза автоответчика выбрасывается; каналы склеиваются по времени в диалог с ролями.
Ключевая идея: VAD снимает именно ту проблему, из-за которой терял whisper. Модель больше не видит 30 секунд тишины с репликой внутри — она получает только кусок, где точно есть речь.
Скорость и прод
- Шестиминутный звонок, оба канала, 2 vCPU — около минуты. Все 154 записи — 28 минут. Обработка в восемь раз быстрее длительности звука.
- Сервер — VPS в РФ, 2 vCPU и 3,8 ГБ памяти, рядом база и API. Модель ~330 МБ на диске, до ~1 ГБ в памяти во время расшифровки.
- Одна модель в памяти, распознавания по очереди, CPU-работа вынесена из event loop в поток. Движок выбирается настройкой: GigaAM по умолчанию, whisper-1 — запасной.
- Каждый вызов пишется в журнал вызовов моделей: модель, секунды звука, задержка, цена — ноль. Новые звонки и голосовые расшифровываются сами, как только Авито отдаёт запись.
- Хронология: днём — сравнение десяти движков на Mac, вечером — прогон 154 звонков серверной сборкой, код, тесты и выкладка. Один день.
Ограничения, которые принял
- По разметке GigaAM не выиграла: 72–73 % против 76 % у whisper-1 на 111 звонках. Аргументы за неё — полнота, локальность и независимость.
- Двенадцать звонков — мало: разброс 70–73 % между десятью кандидатами в пределах шума. WER не измерен — для точности нужен ручной эталон на 10–15 звонков.
- GigaAM тоже ошибается на шуме: «Моси», «Машка», «У вас Андрей Владимир?». Больше текста — это и больше настоящих реплик, и немного мусора.
- Артикулы и номера деталей не надёжны ни у одной модели. Модель не знает, что «5701» и «5902» — разные детали.
- Параметры VAD выставлены по здравому смыслу, на выборке не тюнились. Влияние int8-квантования на точность не измерялось.
Что это значит для вашего продукта
- Не выбирайте модель по чужим рейтингам и не тратьте на выбор неделю. На реальных звонках десять моделей дали одно и то же по сути разговора. Размечьте вручную дюжину звонков, прогоните кандидатов и сравните теги — это один день, и он покажет больше, чем любой бенчмарк.
- Мерьте то, что нужно аналитике. Совпадение тегов с ручной разметкой, а не процент ошибок в словах. Одна и та же LLM размечает все расшифровки одним промптом — и кандидаты сравниваются честно.
- Смотрите, что модель отдаёт, а не только что слышит. T-one слышит не хуже других, но без пунктуации и с числами словами из её текста не достать цену, год и артикул. Для бота и отчёта это важнее процента совпадений.
- Проверьте, сколько речи до расшифровки не доходит. Если аналитика звонков у вас на whisper по раздельным каналам — в отчёте есть дыры, и они не видны. Доля речи по VAD, не покрытая сегментами, по каналам — проверка за день.
- Нарезка по голосу перед распознаванием — обязательный шаг на телефонии. Это дешевле и даёт больше, чем смена модели.
- Локальная модель — это не экономия, а 152-ФЗ и независимость от прокси. На объёмах магазина экономия — доллар-полтора в месяц, решение принимается не по ней. На 2 vCPU модель помещается рядом с базой и API.
- Не чините артикулы в распознавании. Берите их из системы, где они уже есть, — объявления, CRM, заказа. Модель слышит хуже, чем знает ваша база.
Что дальше
- Коррекция артикулов через языковую модель. У звонка есть
itemIdобъявления. После расшифровки — прогон через LLM с заголовком и описанием объявления: «поправь номера деталей по контексту». Дешевле и точнее, чем искать модель распознавания, которая знает каталог Mercedes. - Эталон и WER. 10 звонков с ручной расшифровкой: 3 длинных подбора, 3 с артикулами, 2 шумных, 2 коротких. Отдельная метрика — доля верно распознанных чисел и артикулов.
- GigaAM CTC против RNNT на эталоне. На 111 звонках CTC чуть лучше по разметке — открытый вопрос.
- T-one плюс нормализация чисел. Главный минус T-one — числа словами. С нормализатором она может оказаться конкурентом.